Qué es Screaming Frog y por qué debería importarte
Screaming Frog es un rastreador web. Se instala en tu ordenador (Windows, Mac o Linux) y hace lo mismo que el bot de Google cuando visita tu sitio: le das una URL, pulsas "Start" y en pocos minutos tienes un análisis detallado de la estructura de tu web.
Del nombre no hay una historia oficial verificada: su creador, Dan Sharp, nunca ha dado una explicación pública detallada. Aun así, el nombre pega.
Lo que la distingue de otras herramientas es que los datos son tuyos. No hace falta loguearse en una plataforma cloud ni dejar información de tus proyectos en servidores de terceros.
Es una aplicación de escritorio: la instalas, la ejecutas y obtienes los datos. Tú los controlas.
Y es clara. No filtra información, no te esconde cosas para que subas de plan ni te da un diagnóstico maquillado de tu web. Ves los errores 404, el contenido duplicado y dónde están los problemas, tal cual.
Por eso a algunos consultores no les gusta: el cliente ve los problemas y se pregunta por qué no se detectaron antes. Si tu cliente no quiere malas noticias, esta herramienta no te conviene.
Para qué sirve Screaming Frog en la vida real
Screaming Frog rastrea tu web igual que lo haría el bot de Google. Entra por la página de inicio, encuentra los enlaces, los sigue y repite el proceso hasta catalogar toda la estructura.
Al terminar tienes, entre otras cosas, títulos y meta descripciones (aquí es donde más se falla con la longitud), enlaces internos y externos, códigos de estado HTTP (200, 301, 404...), imágenes con sus atributos ALT, estructura de encabezados y datos estructurados. Todo en tablas que puedes filtrar, ordenar y exportar.
Te cuento un caso en el que fue clave. Hace poco un cliente rediseñó su web y cambió toda la estructura de URLs sin hacer redirecciones. Le pasé un rastreo después del cambio y aparecieron cientos de páginas con error 404.
El tráfico ya había caído en las primeras semanas. Con Screaming Frog encontré la causa enseguida; sin ella habría tardado días en averiguar por qué habían bajado sus rankings. Es lo que hace esta herramienta: saca a la luz los problemas que te hunden el SEO sin que te des cuenta.
Requisitos y cómo instalar (sin drama)
Antes de comprar, comprueba que tu equipo aguanta. Necesitas un sistema operativo de 64 bits (Windows, Mac o Linux). Un equipo muy antiguo puede darte problemas, pero cualquier máquina de los últimos años debería ir bien.
En RAM, el mínimo técnico son 4 GB, pero con eso vas a sufrir, sobre todo con webs medianas. Lo realista son 8 GB, y 16 GB si rastreas webs grandes con frecuencia. Si trabajas como freelance y quieres ir cómodo, esos 16 GB te ahorran frustraciones.
La instalación es sencilla: entra en screamingfrog.co.uk y descarga la versión para tu sistema operativo.
Se instala como cualquier otro programa. Lleva su propio entorno Java integrado, así que no necesitas instalar nada más. Abres la aplicación y ya está.
Para la licencia de pago (245 euros al año) tienes que crear una cuenta en Screaming Frog y comprarla; te dan un código que introduces en el programa. La versión gratuita se descarga y se usa sin licencia.
Primeros pasos tras instalar Screaming Frog
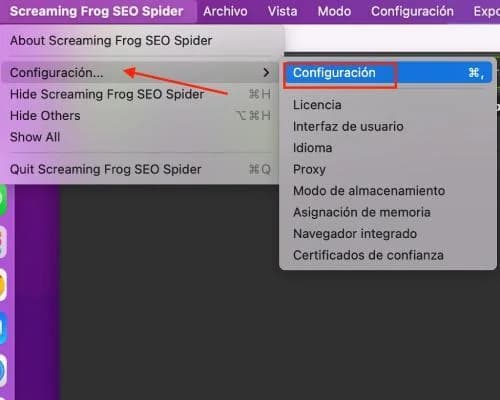
Una vez instalada nuestra ranita, lo primero es ir al menú > Screaming Frog SEO Spider > Configuración > Configuración.
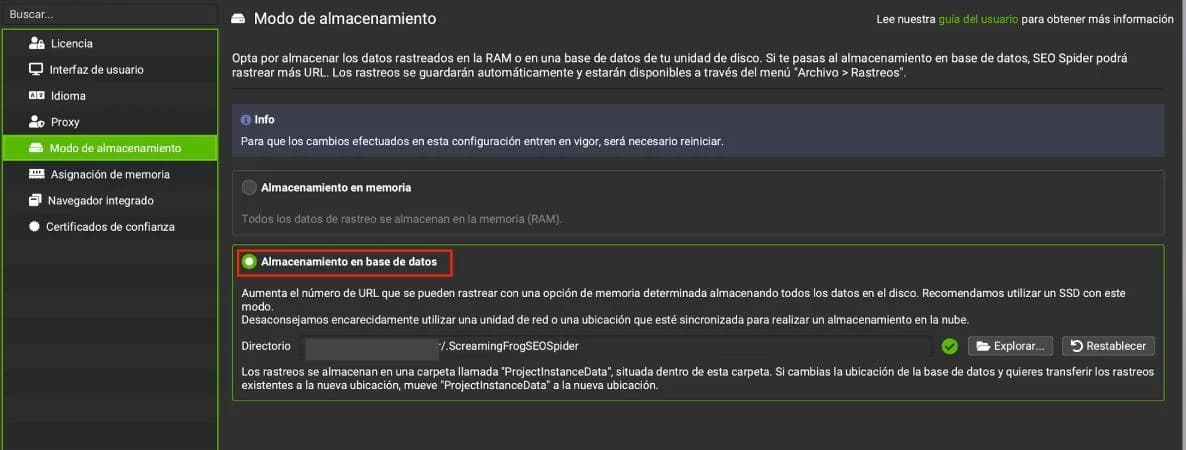
Modo de almacenamiento
Uno de los puntos clave de la configuración es el modo de almacenamiento. Por defecto viene en memoria; te recomiendo cambiarlo a base de datos. Así no usas la memoria del equipo como almacenamiento y los recursos rinden mucho mejor.
Asignación de memoria
Este apartado es de los más importantes y depende de la máquina que tengas. Para sitios pequeños te bastan 4 GB, pero a medida que crece el sitio tendrás que subirlo.
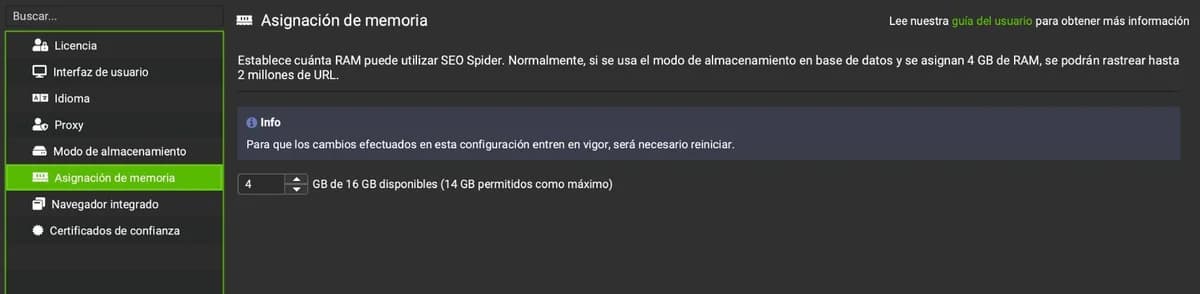
Configuración de Screaming Frog en 2 minutos
Te voy a enseñar las pantallas reales, una por una, con lo que de verdad importa en cada una. Ten en cuenta que hay muchos factores que pueden cambiar la configuración y que puedes desactivar opciones según el caso. Vamos allá.
Spider > Rastreo
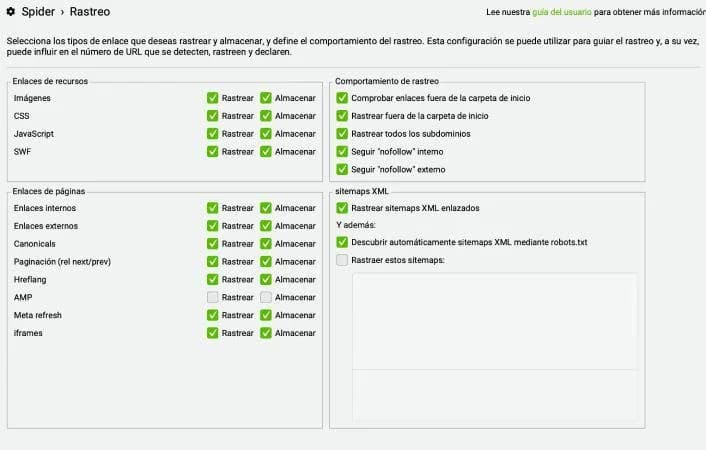
Aquí decides qué rastrea y qué almacena. Por defecto viene todo activado: imágenes, CSS, JavaScript, SWF, enlaces internos y externos, canonicals, paginación, hreflang, meta refresh e iframes. Lo único desactivado de fábrica es AMP, con lógica: cada vez lo usan menos sitios.
En "Comportamiento de rastreo" hay cinco casillas activadas por defecto: comprobar enlaces fuera de la carpeta de inicio, rastrear fuera de la carpeta de inicio, rastrear todos los subdominios (yo siempre lo dejo activado, te sorprendería lo que me he encontrado indexado) y seguir nofollow (vital), tanto interno como externo.
Consejo: la primera vez que rastrees el proyecto de un cliente, activa la casilla de rastrear todos los subdominios. Más de una vez me he encontrado un sitio hackeado con un subdominio aleatorio, y el cliente no sabía nada…
Más abajo, en sitemaps XML, viene activado "descubrir automáticamente sitemaps XML mediante robots.txt". Es justo lo que quieres: que encuentre el sitemap por su cuenta sin que se lo des a mano.
Spider > Extracción
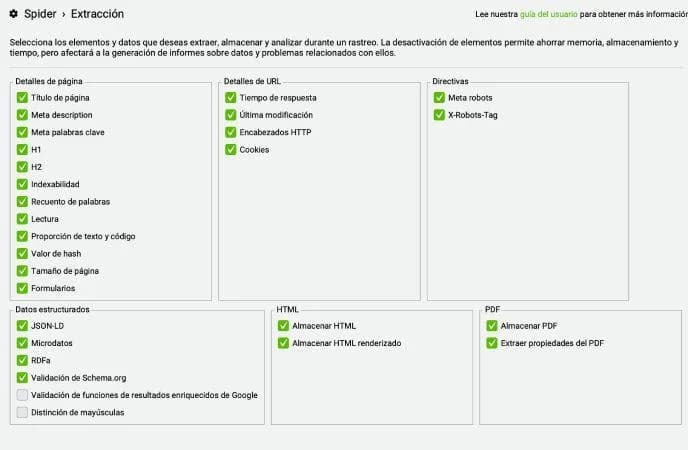
Esta pantalla decide qué información guarda de cada página. Todo lo relevante viene activado de serie: título, meta description, H1, H2, indexabilidad, recuento de palabras, lectura, proporción texto/código, valor hash (sirve para detectar duplicados exactos), tiempo de respuesta, última modificación, cabeceras HTTP, cookies, meta robots y X-Robots-Tag.
En datos estructurados están activados JSON-LD, Microdatos, RDFa y la validación contra Schema.org, así que puedes auditar el schema sin tocar nada.
Solo vienen desactivados la "validación de resultados enriquecidos de Google" y la "distinción de mayúsculas". Actívalos únicamente si vas a validar rich snippets al detalle; en el 90 % de las auditorías no hace falta.
Spider > Límites
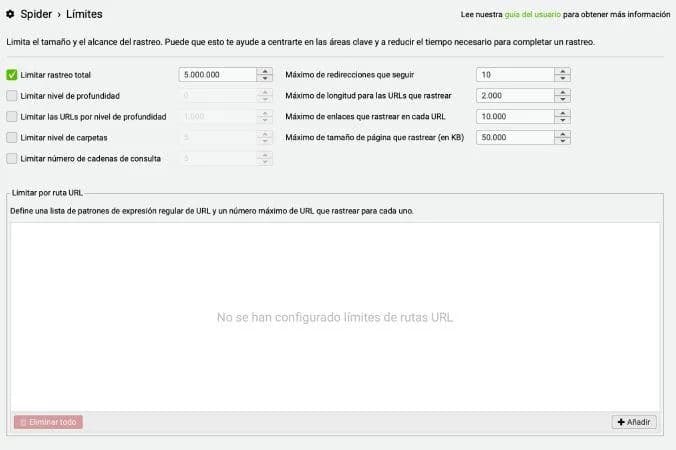
Aquí controlas cuántas URLs rastrea como máximo y hasta qué profundidad. Lo dejo en los valores por defecto, salvo en webs enormes: ahí limito el rastreo total para que no se me vaya de las manos.
Spider > Renderizado
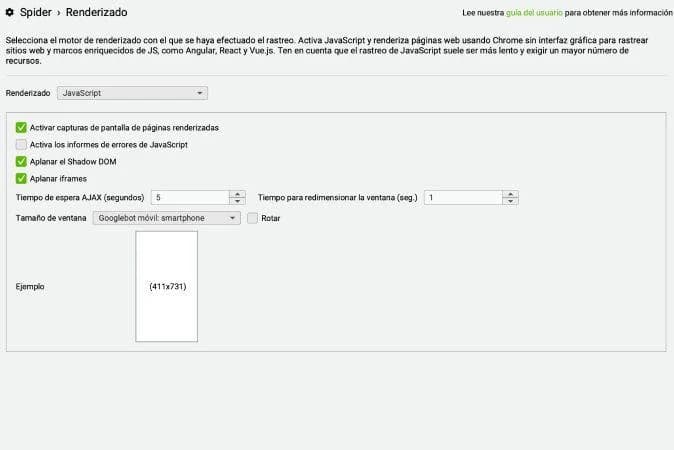
Aquí eliges el motor de renderizado. Por defecto es JavaScript, lo correcto para el 90 % de las webs modernas: sin él no ves nada de lo que cargan React, Vue o Angular. También vienen activadas las capturas de pantalla de páginas renderizadas, aplanar Shadow DOM y aplanar iframes.
El tamaño de ventana por defecto simula a Googlebot móvil (smartphone, 411x731 píxeles), que es el que usa Google para indexar desde 2020 con el Mobile First Indexing.
El tiempo de espera AJAX está en 5 segundos. Si tu web carga contenido muy lento vía AJAX, súbelo; si no, la herramienta se rinde antes de que termine y los datos salen incompletos.
Spider > Avanzado
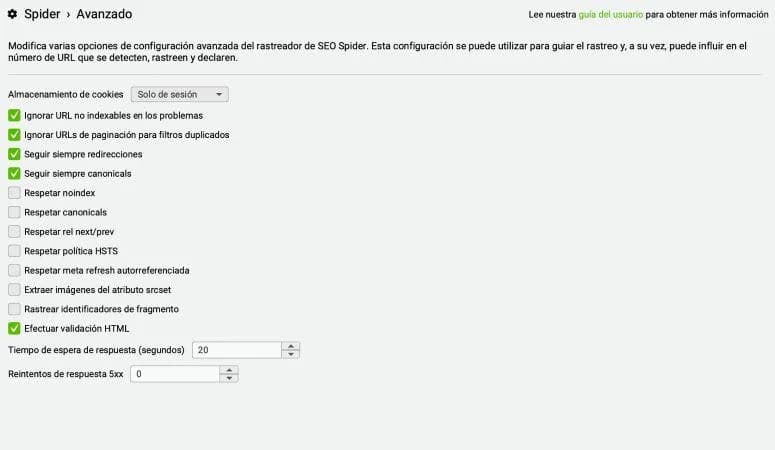
Aquí hay una distinción que confunde a mucha gente: están activados "seguir siempre redirecciones" y "seguir siempre canonicals", pero desactivados "respetar canonicals" y "respetar noindex".
No es una contradicción. Screaming Frog sigue el rastro de todo para que veas la cadena completa, pero no deja de contar una URL solo porque tenga un canonical a otra o esté en noindex.
Es el modo "raw": te enseña la realidad completa y no lo que Google decidiría hacer con ella. También están activados "ignorar URL no indexables en los problemas" y "efectuar validación HTML".
El tiempo de espera de respuesta es de 20 segundos y los reintentos de respuesta 5xx están en 0. Si un sitio te da muchos 5xx intermitentes (servidor lento, que no caído), sube el valor a 1 o 2 para no contar como error lo que fue un simple timeout puntual.
Spider > Preferencias
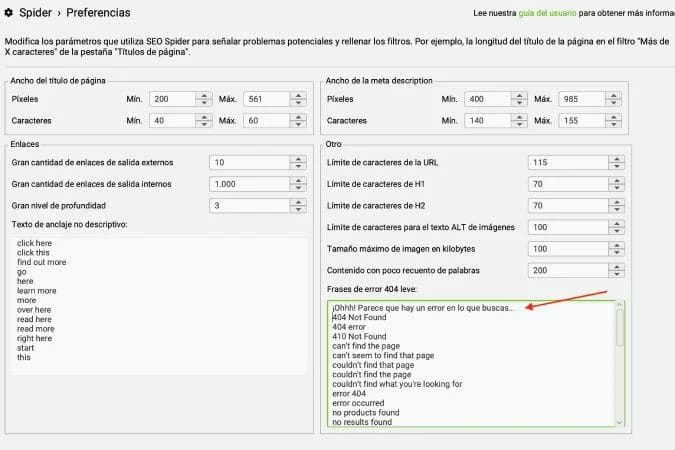
Esta pantalla define los umbrales con los que marca algo como "problema". Para el título de página: 200-561 píxeles y 40-60 caracteres. Para la meta description: 400-985 píxeles y 140-155 caracteres.
Ojo con el límite de imagen: 100 kilobytes exactos. Si una imagen pasa de ahí, Screaming Frog te la marca sola.
La profundidad "grande" empieza en 3 clics desde la home, y la cantidad "grande" de enlaces internos de salida, en 1.000.
También incluye una lista de textos de anclaje no descriptivos ("click here", "read more", "más info"...) que marca como flojos. Vale la pena revisarla y añadir los tuyos en español si el cliente los usa mucho. Un consejo: cuando reviso una web por primera vez, busco su página 404, copio el texto del error que muestra y lo pego en las frases de error leve (soft 404). Así Screaming Frog detecta también las páginas que dicen "no encontrado" pero devuelven un 200.
Contenido > Duplicados
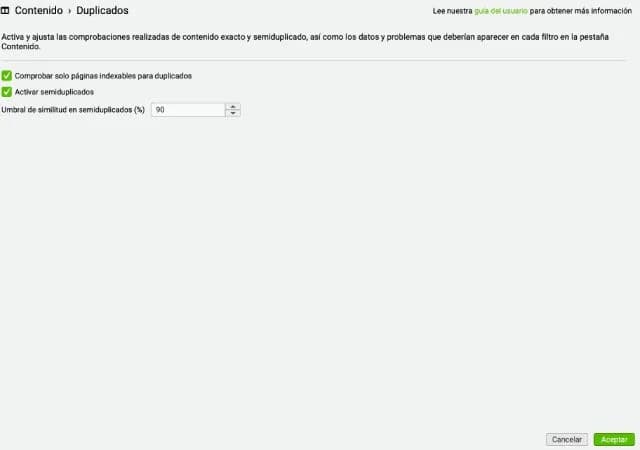
Detecta duplicado exacto y "casi duplicado". El umbral de similitud viene en un 90 %. Por defecto solo comprueba páginas indexables, lo que tiene sentido: no te interesa que marque como duplicado algo que ya está en noindex.
Contenido > Área del contenido
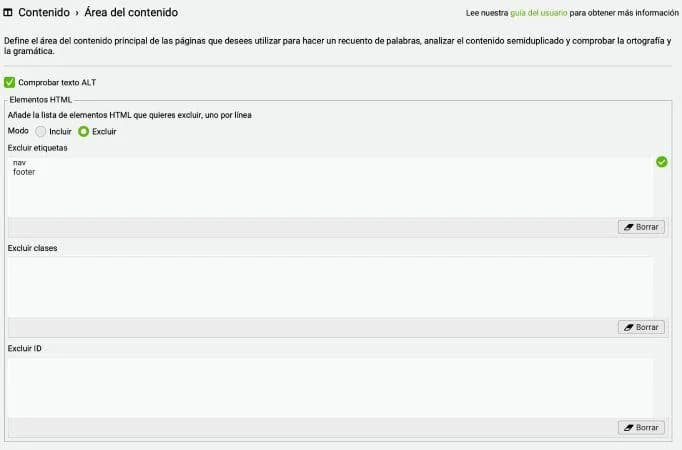
Aquí defines qué parte del HTML cuenta como "contenido real" para el recuento de palabras, los duplicados y la ortografía.
Por defecto excluye nav y footer, y es justo lo que recomiendo: si no lo excluyes, cualquier menú o pie de página repetido en todas las páginas contamina el análisis de duplicados.
Contenido > Ortografía y gramática
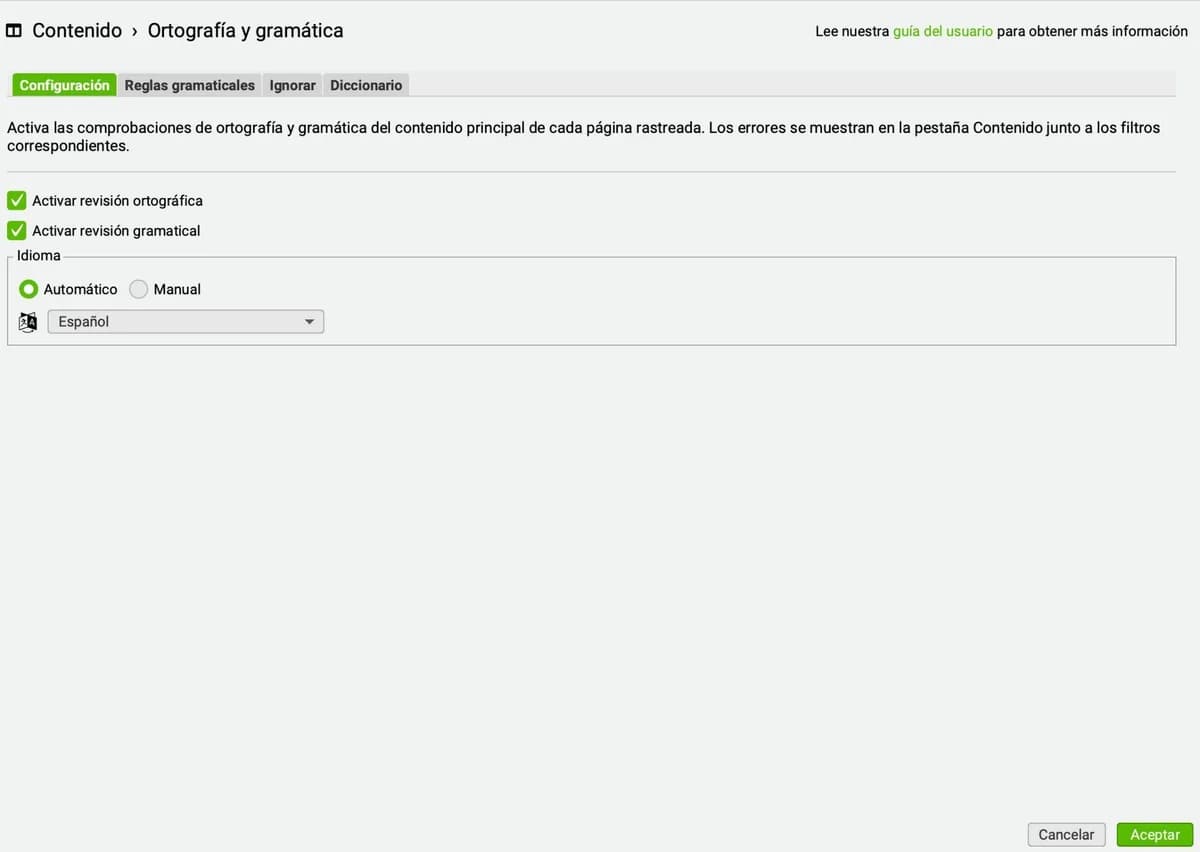
Activa la revisión ortográfica. Viene en modo automático, pero si el cliente tiene contenido en varios idiomas mezclados en el mismo dominio, ponlo en manual y selecciona español a mano. Si no, a veces detecta mal el idioma de una página y te llena de falsos positivos.
robots.txt
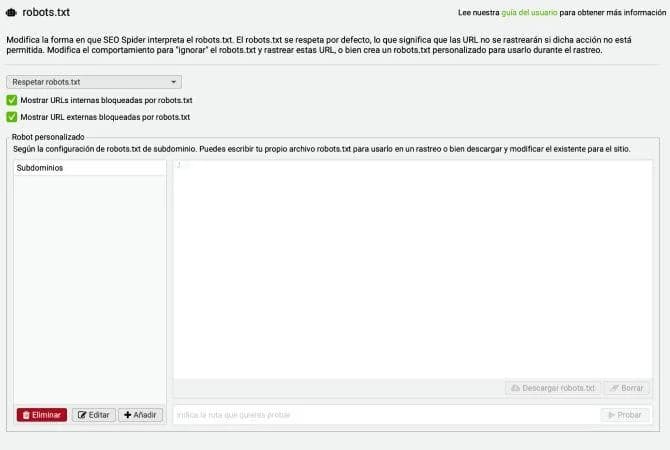
Por defecto Screaming Frog respeta el robots.txt del sitio: no rastrea lo que este le prohíbe. Lo útil es poder ignorarlo cuando auditas tu propia web, ver qué URLs bloqueó (interna y externamente) y hasta escribir un robots.txt personalizado para probar cambios antes de subirlos a producción.
User-Agent
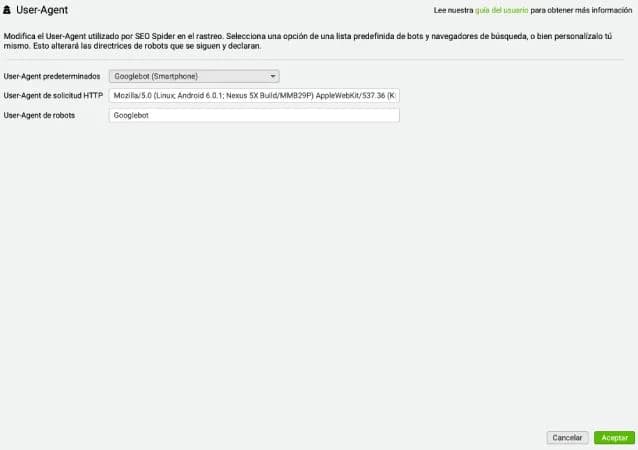
Me gusta rastrear como Googlebot (Smartphone), con la cadena de user-agent real que usa Google, y casi siempre lo dejo así: lo que quieres ver es cómo te ve Google, no cómo te ve un usuario. Solo lo cambio si el cliente sospecha que su servidor sirve contenido distinto según el user-agent (cloaking, a veces sin querer).
Velocidad
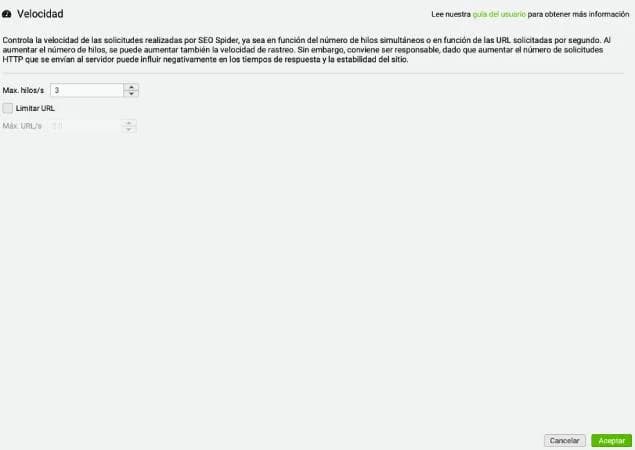
Controla cuántos hilos usa a la vez y cuántas URLs por segundo pide. Yo lo dejo en 3 hilos, y lo bajo aún más cuando rastreo sitios muy grandes.
Análisis del rastreo
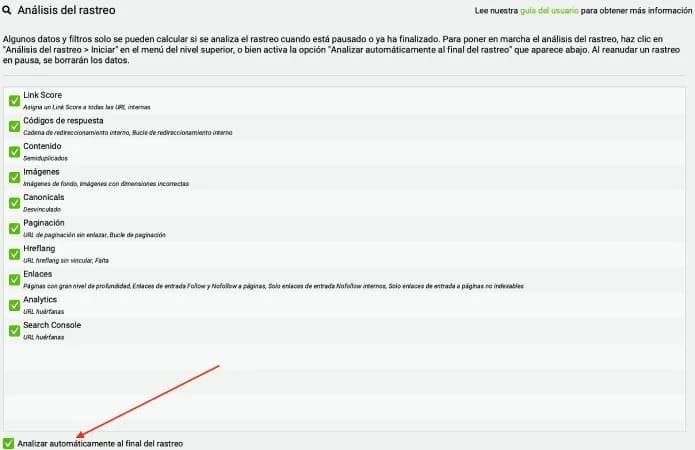
Esta pantalla se ejecuta al terminar el rastreo (o puedes activar que corra sola con "analizar automáticamente al final").
Aquí vive el Link Score, junto con un buen paquete de detecciones que no ves durante el rastreo en vivo: cadenas y bucles de redirección interna, contenido semiduplicado, imágenes de fondo con dimensiones incorrectas, canonicals desvinculados, bucles de paginación, hreflang sin vincular o inexistente y, ojo, las URLs huérfanas, tanto vía Analytics como vía Search Console.
Sobre las huérfanas: sin conectar GA o GSC, Screaming Frog no tiene forma de saber que una página así existe.
Ventajas que te harán ahorrar dinero y dolores de cabeza
Screaming Frog cuesta 245 euros al año, menos de 20 euros al mes. SEMrush empieza en torno a 112 euros al mes en su plan de entrada y Ahrefs en torno a 129 euros en su plan lite. Comparada con eso, es una herramienta muy barata para lo que da.
Lo mejor es la privacidad: tus datos se quedan en tu ordenador y no se suben a ningún servidor cloud. Si trabajas con clientes de sectores sensibles (finanzas, derecho, medicina), eso importa, y algunos directamente no te dejan usar herramientas cloud. Yo he tenido clientes que solo me permitían usar Screaming Frog por esa razón.
Luego está la velocidad. Como corre en local depende de tu RAM y tu CPU, pero rastrea bastante rápido: un sitio de tamaño medio lo hace en minutos. En las plataformas cloud tienes límites de rastreos al mes, tiempos de espera y otras restricciones; aquí rastreas cuanto quieras.
También tienes control granular sobre lo que rastreas. ¿Solo páginas de producto? Excluyes el resto. ¿Ciertos parámetros de URL? Los ignoras. Te ahorras tiempo al no analizar URLs que no te interesan.
Y no te vende análisis falso: no te dice "todo va bien" cuando todo va mal. Algunos consultores jóvenes me preguntan cómo elijo entre Screaming Frog y Semrush. No son lo mismo: Semrush es estrategia general y Screaming Frog es auditoría técnica pura. Al final necesitas las dos.
La comunidad también cuenta. Hay mucha gente usando Screaming Frog y compartiendo trucos. No es como un servicio cloud, donde si tienes un problema esperas a que responda soporte: aquí, si algo no funciona, encuentras hilos en Reddit explicando cómo arreglarlo.
Las desventajas reales (sin rodeos)
No todo son flores. Estas son las limitaciones que debes conocer.
La versión gratuita rastrea un máximo de 500 URLs. Para webs pequeñas está bien; para algo más grande necesitas la de pago. Es una limitación artificial, sí, pero real.
La curva de aprendizaje es empinada. La primera vez que abres Screaming Frog no resulta intuitivo: hay muchas opciones y configuraciones y no sabes qué significa cada una. He visto a freelancers nuevos comprar la licencia y abandonarla porque "es muy complicado". Si esperas un software vistoso y pulido, esto no es para ti. Screaming Frog es para quien quiere datos, no para quien quiere algo bonito.
El consumo de RAM es real. Si rastreas una web gigante (más de 100.000 URLs) necesitas una máquina potente; yo probé con una vieja y el sistema se ralentizó por completo. Lo mínimo son 8 GB de RAM, con menos tendrás problemas, y para webs muy grandes lo ideal son 16 GB.
No tiene análisis de competencia integrado como Semrush. Puedes rastrear el sitio de un competidor, pero sin datos comparados de backlinks o rankings: es solo una auditoría técnica de su web.
Si una web carga el contenido de forma dinámica muy compleja, puede que Screaming Frog vea solo una parte. Eso sí, las dos versiones pueden renderizar, así que no es una diferencia entre la gratuita y la de pago.
Y la más importante: es una herramienta de escritorio. Tienes que instalarla y tu ordenador tiene que estar encendido mientras rastrea.
Errores típicos que he visto cometer (y que tú probablemente harás)
Llevo muchos años trabajando con otros consultores y veo los mismos errores con Screaming Frog una y otra vez.
Error 1: No configurar bien los parámetros de rastreo. Muchos lo rastrean todo sin exclusiones, y Screaming Frog acaba recorriendo el carrito entero, los filtros de producto, los parámetros de sesión... El resultado es un rastreo que tarda mucho más de lo necesario y un informe con URLs "duplicadas" que son en realidad la misma página con parámetros distintos. Antes de rastrear, configura SIEMPRE qué quieres excluir.
Error 2: No usar los filtros de resultados. Haces el rastreo, ves miles de URLs, te agobias y lo dejas. Filtra solo por 404, o solo por títulos duplicados, o solo por metas vacías. Screaming Frog se vuelve mucho más manejable cuando miras un problema cada vez.
Error 3: Confundir "rastreado" con "indexado". Screaming Frog rastrea lo que puede alcanzar, pero Google puede decidir no indexar esas páginas por otros motivos. He visto a gente decir "Screaming Frog dice que tengo 5.000 URLs" cuando en GSC Google solo indexa 1.000, y puede ser perfectamente correcto: Google tiene sus propios criterios. Screaming Frog te enseña lo que hay, no lo que Google quiere indexar.
Error 4: No actualizar el software. Se actualiza con regularidad, y quedarte atrás significa perder mejoras y correcciones de bugs, y a veces tener incompatibilidades. Actualiza cada mes.
Error 5: Tomar decisiones solo con la pestaña "Overview". Es un resumen: útil, pero incompleto. Para saber qué pasa de verdad hay que entrar en las pestañas específicas (Internal, Images, External, etc.). Un cliente me dijo una vez "Screaming Frog dice que todo está bien" basándose solo en la Overview. Cuando miré con detalle, tenía más de 100 enlaces rotos.
Error 6: Rastrear sin autenticación un sitio con áreas protegidas. Si tu web tiene una zona de login (clientes, miembros, etc.), Screaming Frog no puede entrar sin que configures la autenticación, y acabas creyendo que tienes menos páginas de las que tienes. Si necesitas auditar esas áreas, tendrás que configurar las credenciales en la herramienta.
Error 7: Exportar mal los datos. Screaming Frog exporta a CSV, JSON y más formatos, pero si no sabes qué columnas necesitas, acabas con un Excel gigante lleno de información irrelevante. Exporta solo lo que te haga falta: tu cliente no quiere un Excel de 50 columnas, quiere un informe limpio con los 4 problemas principales.
Casos de uso reales donde te salva
He trabajado con cientos de webs distintas. Te cuento casos reales en los que Screaming Frog fue lo que resolvió el problema.
Una agencia rediseñó por completo el sitio de su cliente. Cambió la estructura de URLs, pasó de estática a dinámica y se olvidó de las redirecciones. Después, los rankings bajaron.
El cliente me llamó para pedirme ayuda. Cogí el listado de URLs del sitio antiguo que tenía guardado, lo cargué en Modo Lista, activé "Seguir siempre redirecciones" y exporté el informe completo de redirecciones. Tenía cientos de URLs sin redirect.
Con un solo informe de Screaming Frog el cliente vio exactamente dónde estaba el problema. Se pusieron a redirigir y, pasado un tiempo, los rankings se recuperaron.
Una tienda online tenía las conversiones por los suelos sin razón aparente. Habían hecho SEO e invertido en ads, y nada. Me pidieron una auditoría.
Hice un rastreo con Screaming Frog y vi que tenían miles de fichas de producto indexadas, pero solo unas pocas con el schema de producto bien implementado. Sin rich snippets, los usuarios confiaban menos a la hora de comprar. Cuando arreglamos el schema en todas las fichas, las conversiones mejoraron bastante. Este tipo de auditoría técnica es donde más brilla Screaming Frog.
Un blog de noticias tenía un problema de canibalización. Escribía sobre "mejores herramientas de SEO" y "herramientas SEO baratas", y las dos páginas posicionaban sin que quedara claro cuál priorizar. Usé Screaming Frog para ver la estructura de enlaces internos.
Una de las páginas tenía muchos menos enlaces internos que la otra. La conclusión era clara: el sitio favorecía sin querer una versión sobre la otra. Redirigí la menos enlazada a la principal, unifiqué el link juice y la página principal mejoró posiciones.
Un cliente vendía en varios países y tenía distintos subdominios (es.dominio.com, pt.dominio.com, en.dominio.com). Screaming Frog me mostró que no tenía hreflang configurado.
Google no sabía qué versión servir a cada usuario y estaba mezclando el tráfico. Arreglamos los hreflang y el tráfico de cada país mejoró, porque Google dejó de enseñar la versión equivocada.
No son casos inventados: pasan constantemente, y Screaming Frog te permite detectarlos rápido, cuando de otro modo tardarías mucho. Puedes ver más casos como estos en mis casos de éxito.
Análisis de competencia: lo que no te dicen
Mucha gente usa Screaming Frog solo para auditar su propia web, y se deja un uso muy bueno: analizar a la competencia.
Rastreo los sitios de mis competidores principales. No para espiar (bueno, un poco), sino para entender su estructura. ¿Cuántas páginas indexan? ¿Cuántos enlaces internos tienen? ¿Qué estructura de títulos usan? ¿Usan datos estructurados y de qué tipo?
He encontrado competidores con títulos demasiado cortos, descripciones vacías y enlaces a páginas 404. He visto webs que posicionaban bien con una estructura técnica pésima. Eso me ayuda a pensar: "vale, no necesito una estructura perfecta para posicionar si mi contenido es lo bastante bueno".
También rastreo a la competencia cuando preparo estrategias de linkbuilding. Ver cómo enlazan sus recursos internos me ayuda a entender qué páginas les dan más autoridad.
Eso sí, cuidado: en sitios grandes y complejos Screaming Frog no lo rastrea todo perfectamente. No es como rastrear tu propio sitio, donde tienes acceso total: ves solo lo que vería cualquier usuario siguiendo enlaces. Es un análisis superficial, pero útil.
Con toda esa información afino mi propia estrategia. No copio lo que hace la competencia; evito sus errores y me apoyo en sus puntos fuertes.
Screaming Frog Cloud: la alternativa online
Hace unos años, Screaming Frog lanzó Screaming Frog Cloud, la versión online basada en navegador. No hay que instalar nada, solo iniciar sesión en la web.
La idea es buena: rastreas desde cualquier dispositivo, no consumes la RAM de tu ordenador y puedes programar rastreos automáticos que se ejecutan en los servidores de Screaming Frog.
La realidad es que es menos potente que la versión de escritorio, con menos funcionalidades y más limitaciones. Para casos concretos (programar rastreos automáticos, acceder desde varias máquinas, no ocupar espacio local) funciona bien.
Si lo que necesitas es programar un rastreo semanal y recibir el informe, Cloud cumple. Si necesitas todo lo que ofrece la versión de escritorio, se te queda corta.
Yo uso la de escritorio el 99 % del tiempo. Cloud solo cuando necesito acceder desde la tableta o lanzar un rastreo automático que no puedo configurar fácilmente en cron.
Si trabajas en remoto, Cloud puede tener sentido. Si trabajas desde una oficina con tu equipo fijo, es mejor la de escritorio.
Errores avanzados que cometen hasta los "expertos"
Ahora que ya conoces lo básico, vamos con los errores de quienes llevan años usándolo.
Mucha gente usa Screaming Frog pero no cruza los datos con Analytics. Ves un sitio con muchas URLs indexadas, pero ¿cuántas reciben tráfico real? Conecta Analytics y lo sabrás. Encontrarás páginas "fantasma" que crees que generan tráfico y no lo hacen, o tráfico en sitios donde no debería haberlo.
Tampoco revisan las URLs huérfanas. Una página sin ningún enlace interno es invisible para Screaming Frog en un rastreo normal; solo la ves si la metes vía sitemap o conectas Analytics. Así encontré varias fichas de producto huérfanas: existían, estaban indexadas, pero nadie las visitaba porque ni el propio sitio las enlazaba.
Otro error es no tener en cuenta el crawl budget. Google dedica un presupuesto limitado de rastreo a cada sitio por día. Si tu web tiene una estructura complicada (parámetros innecesarios, páginas duplicadas), gastas ese presupuesto en basura y Google no rastrea tus páginas nuevas importantes. Screaming Frog te lo enseña: usa esos datos para mejorar la estructura.
Muchos ven un problema técnico, lo exportan a un Excel, lo archivan y nunca lo arreglan. Un informe no sirve de nada si no actúas. He visto clientes con auditorías antiguas sin implementar. Sin acción posterior, Screaming Frog es inútil.
Otros exigen que todas las URLs devuelvan un 200. A veces los 301 son correctos (redirecciones necesarias) y los 410 también, si la página se eliminó a propósito. No todo código distinto de 200 es un error.
También hay quien no configura el User-Agent. Si tu sitio sirve contenido distinto según el User-Agent (algo que algunos hacen y no deberían), Screaming Frog podría no verlo bien. Comprueba que tu sitio sirve el mismo contenido a todos los bots.
Y el más peligroso: rastrear sitios ajenos con demasiada agresividad. Si rastreas la web de un competidor a mucha velocidad, puede bloquearte su firewall o incluso podrías incumplir sus términos de servicio. Ten cuidado.
Trucos personales que me ahorran horas
Tras 10 años con esta herramienta, estos son los trucos que aplico a diario.
Guardo siempre los rastreos. Screaming Frog permite guardar un rastreo ("Save crawl") para compararlo después. Hago rastreos mensuales de mis clientes grandes, los guardo y comparo mes a mes con el modo Compare integrado. Para usarlo necesitas tener el Storage Mode en Database, no en Memory, que es el modo por defecto. Hace el diff automáticamente: qué 404 nuevo ha aparecido, qué título ha cambiado, qué página ha perdido enlaces internos. Antes lo hacía a ojo, comparando exports en Excel; ahora se hace directo en la herramienta y me ahorra horas.
Uso expresiones regulares para excluir basura. Patrones como .*\?utm_.*, .*\?sessionid.* o /wp-json/.* (en sitios WordPress) los excluyo siempre desde Include/Exclude. El rastreo queda mucho más limpio y rápido.
Creo informes separados por problema: uno de 404, otro de títulos duplicados, otro de metas vacías. No hago uno gigante con todo, porque los clientes lo entienden mejor cuando ven un problema cada vez.
Integro siempre GSC. Da trabajo la primera vez que lo configuras, pero luego es automático. Así comparo las páginas que rastrea Screaming Frog con las que GSC dice que rastrea, y si hay diferencias, investigo por qué.
En webs enormes no rastreo todo de una vez, sino por secciones: primero la home y las categorías principales, luego las subcategorías y después los productos. Así veo antes dónde están los problemas más graves.
Cuando un cliente me dice "mi web está bien", hago un rastreo y exporto en un solo informe los 404, los duplicados, los títulos cortos, todo junto. Suele sorprenderles: muchos descubren duplicados que no conocían.
Y por último: comunico siempre en términos del cliente. No digo "tienes URLs con respuesta 404", digo "tienes páginas rotas donde tus clientes potenciales llegan a un error". El impacto es muy distinto.
Conclusión: ¿necesitas Screaming Frog?
La respuesta honesta es: depende.
Si cobras por auditorías SEO, sí, sin dudarlo, y la de pago: vale cada euro. Si quieres ver cómo se ve una auditoría de tu propia web, puedes pedir una gratis aquí.
Si tienes una web personal pequeña, la versión gratuita es suficiente.
Si trabajas en marketing digital sin ser especialista en SEO, no será tu herramienta principal, pero la necesitarás en casos concretos. Y si necesitas a alguien que la use de forma profesional, puedo ayudarte con una consultoría de SEO personalizada.
Si eres cliente y quieres entender qué te dice tu auditor de SEO, Screaming Frog te sirve para aprender. Al menos sabrás de qué habla cuando mencione problemas técnicos.
Después de todos estos años me sigue siendo imprescindible. La herramienta es veterana, la verdad, y algunos piensan que está pasada. Pero hace lo que tenía que hacer hace años y lo sigue haciendo igual. En un mundo de herramientas que cambian de interfaz, de precios y de funcionalidades cada dos por tres, Screaming Frog es estable: haces un rastreo hoy, otro dentro de unos años y sabrás leerlo igual.
No te voy a vender que Screaming Frog sea la herramienta perfecta. Tiene limitaciones, una curva de aprendizaje y exige una máquina potente. Pero en lo suyo es la mejor, y a ese precio es difícil no recomendarla.